这些文章和案例研究表明,只要改进算法,充分利用现代硬件,并关注整个系统的设计,软件运行速度往往能提升十倍甚至更多。
等你证明自己懂得怎么用好第一台计算机了,你才能拥有第二台。
Paul Barham,引自“可扩展性!但代价是什么?”
- 隐性知识 / 机械同理心
- “欢迎来到丛林”(探讨 CPU 设计与摩尔定律;参见“你的计算机里有多少台计算机?”)
- “顶层还有很大空间:摩尔定律之后是什么在推动计算机性能?”,Leiserson 等人,2020 年(探讨基于端到端原则的系统设计所带来的收益[1])
- “可扩展性!但代价是什么?”,McSherry 等人,2015 年(探讨笔记本电脑性能超越集群的情况:良好基准测试的重要性;“大数据”装不进笔记本);“命令行工具比你的 Hadoop 集群快 235 倍”
- “运行 Stack Overflow 需要什么”,Nick Craver;“退出云服务,我们在 5 年内能省下 700 万美元”,David Heinemeier Hansson;“在一台机器上跑推特生产环境?100Gbps 网卡和 NVMe 确实很快”
- “黑客剖析:破解者如何洗劫像 qeadzcwrsfxv1331 这样的密码;三名破解者为 Ars 破解了 16000 多个哈希密码,成功率达 90%”;“以 41 GB/s 的速度计算 Adler32 校验和”
- “暴力破解的科学”
- “括号配对成色速度提升 10000 倍”
- “每秒解析 GB 级 JSON”,Langdale 与 Lemire,2019 年
- 59 GB/s 的 FizzBuzz;“现代存储已经够快了,烂的是 API”;“单物理核达成 1000 万 IOPS。#io_uring #linux”;“单台 ThreadRipper 工作站实现 1100 万 IOPS 和 66 GB/s 的 IO”
- “C10K 问题”,Kegel,2001 年;“在 FreeBSD 上以 50 GB/s 分发 Netflix 视频”,Gallatin,2021 年 / “以 100 GB/s 甚至更高的速度分发 Netflix 视频流量”,Gallatin,2022 年
- “多播与市场”(探讨高频交易中的网络优化与机械同理心)
- “算法改进的真实故事”
- 结合 Codec2 与 WaveNet 解码器,为微型播客提供超低码率音频(1 小时 = 1MB)
- “计算机很快,但你并不知道”(用并行化 C++ 替换速度缓慢的 pandas,速度提升 6000 倍)
- “在单台服务器上将 SQLite 扩展至 400 万 QPS(EC2 与裸机对比)”,Expensify;“比 3.7.17 块 50%”(“……我们通过数百项微优化实现了这一目标。每项微优化带来的性能提升可能只有区区 0.05%。”)
- “优化故事——量子力学模拟提速”;“提速 14000 倍,即计算机科学大获全胜”
- “缩短管线:实现亚秒级的迭代时间”,Frykholm,2012 年(探讨游戏开发优化)
- “Michael Abrash 如何让《雷神之锤》的帧率翻倍”,Fabien Sanglard,2026 年
- “十亿行挑战(1BRC):Java 版如何步步优化从 71 秒降至 1.7 秒”(Go 语言需 4 秒,C 语言仅需 0.5 秒)
- “GCC 编译器对决人类——手写汇编快 119 倍 💻🆚🧑💻”;“Python、C、汇编——余弦相似度计算提速 2500 倍 📐”;“在 Haswell 架构上以近乎 memcpy 的速度对 ASCII 编码整数求和”(“比下面这种朴素的 C++ 解法快 320 倍”)
- “如何让 Python 程序提速 114000 倍”,David Schachter,2012 年 12 月 4 日
- “普洛斯彼罗挑战”(渲染一种矢量图形玩具语言;简单实现需 15000 毫秒 → 3750 毫秒 → 6.3 毫秒 → 3.9 毫秒,总计提速 3800 倍)
- libdivide:“在当下的 CPU 上,64 位整数除法可提速近 10 倍,32 位整数除法可提速近 5 倍”
- “优化 MOS 6502 CPU 的 Apple 图像解码器,将时间从 70 分钟缩短至 1 分钟”
- “最小布尔公式”,Russ Cox
- “利用 AVX-512 实现全 Unicode 搜索,速度是 ICU 的 50 倍”
- “mold:一款大规模并行链接器”,Ueyama,2026 年
- Demoscene(演示场景):
- “8088 统治”:“我是如何创作出这款在 1981 年的 IBM PC 上播放相当清晰的全动态视频程序的” / 第二部分
- “意识诞生”(大小仅 256 字节;作为对比,上面那条链接到该演示的 Markdown 源码就有 194 字节长,而演示视频更高达数百万字节)
- Casey Muratori:refterm v2、《见证者》(Witness)的寻路算法(总结)
- 算法进展:
- “6 个领域的算法进展”,Grace,2013 年
- “SAT 求解的时间跳跃挑战”,Fichte 等人,2020 年(硬件过剩:自 2000 年以来,SAT 求解性能提升了约 2.5 倍,软件和硬件进步各占一半,不过软件略多一些——在旧硬件上运行新软件,胜过在新硬件上运行旧软件。)
- 2019 年破解 LCS35 挑战
- “衡量硬件过剩”,hippke(“如果使用如今的算法,计算机早在 1994 年就能在一台当时的台式机上击败国际象棋世界冠军”)
- 内存局部性:
- “每个程序员都该懂的内存知识”,Drepper,2007 年
- “你做错了:以为自己已经掌握了服务器性能的艺术?再想想吧。”,Poul-Henning Kamp,2010 年(探讨如何使用缓存无关的 B-堆结构将 Varnish 性能优化 10 倍)
- “LMAX 架构”,Fowler,2011 年(TigerBeetle)
- “将 CRDT 提速 5000 倍:一场优化的冒险”
- “原地超标量样本排序(IPS4o):工程化原地(共享内存)排序算法”,Axtmann 等人,2020 年;“向量化且性能可移植的快速排序”,Blacher 等人,2022 年
- “大数据中具有大编辑距离的快速近似字符串匹配(2015)”
- “ParPaRaw:大规模并行解析分隔符分隔的原始数据 CSV”,Stehle 与 Jacobsen,2019 年
- “将我们的电子表格引擎从几千个单元格扩展到几十亿个:从字典映射到数组”,Lukas Köbis,2022 年
- “持久 RNN:将循环权重暂存于片上”,Diamos 等人,2016 年;“FlashAttention:具备 IO 感知、快速且内存高效的精确注意力机制”,Dao 等人,2022 年
- 面向现代硬件的算法
- 用快速动态规划求解第 14 题
- 深度学习 / 深度强化学习:
- 通过暴力并行,在 ARCHER 超级计算机上用不到 4 分钟训练 A3C 破解 Atari 版《碰碰弹子台》
- “megastep 帮你在一张 GPU 上构建百万 FPS 的强化学习环境”,Jones
- “《2048》的数学原理:用马尔可夫决策过程实现最优解”
- 暴力破解《打砖块》(在一个经过优化的 C++ 模拟器里,通过深度优先搜索一个近似的马尔可夫决策过程,耗费 6 个 CPU 年得出最优解;玩法极其疯狂——就像国际象棋的残局库一样,让人初窥超级智能的端倪)
- “Sample Factory:结合异步强化学习,以 100,000 FPS 从像素实现第一人称视角 3D 控制”,Petrenko 等人,2020 年;“Megaverse:以每秒一百万次经验模拟具身智能体”,Petrenko 等人,2021 年;“Brax:用于大规模刚体物理模拟的可微物理引擎”,Freeman 等人,2021 年;“Isaac Gym:用于机器人学习的高性能 GPU 物理模拟”,Makoviychuk 等人,2021 年(Rudin 等人,2021 年);WarpDrive
- “用于深度强化学习的大批量模拟”,Shacklett 等人,2021 年
- “利用棋盘游戏扩展缩放定律(Scaling Laws)”,Jones,2021 年
- “用深度强化学习精通即时战略游戏:凡人版”,Winter
- “缩减深度学习的规模”,Greydanus,2020 年
- “用于可扩展强化学习的 Podracer 架构”,Hessel 等人,2021 年(高效利用 TPU Pod:例如在 TPU-2048 上以 4300 万 FPS 的帧率不到 1 分钟破解《碰碰弹子台》);“Q-DAX:通过大规模并行加速机器人的质量-多样性”,Lim 等人,2022 年;“EvoJAX:硬件加速的神经进化”,Tang 等人,2022 年;“JaxMARL:在 JAX 中的多智能体强化学习环境”,Rutherford 等人,2023 年
- “在 CUDA(NVIDIA RTX 2080)上以每秒 100 万步的速度模拟训练 Ant(蚂蚁模型),利用了微型可微模拟器(TDS)和 C++ 增强随机搜索。”(Erwin Coumans,2021 年)
- “这个《贪吃蛇》环境模拟了 1400 万条蛇,并以每秒 100 万步的速度训练贪吃蛇。”
- “TextWorldExpress:以每秒一百万步的速度模拟文字游戏”,Jansen 与 Côté,2022 年
- “打破《HATETRIS》(最难俄罗斯方块)世界纪录”,Dave 与 Filipe,2022 年
- “NAVIX:利用 JAX 扩展 MiniGrid 环境”
- “并行 Q 学习(PQL):在大规模并行模拟下扩展离线强化学习”,Li 等人,2023 年
- 延迟 / 界面:
- “关键在于延迟,笨蛋。”
- “跨大西洋 ping 的速度比往屏幕上发送一个像素还快?”
- “计算机延迟:1977—2017”
- “键盘延迟”
- “终端延迟”;改进 GNOME 终端
- “本地优先软件:不管有没有云,数据都归你所有” / Kleppmann 等人,2019 年
- “网页臃肿”[2]
- “Starline 项目:一套高保真网真系统”,Lawrence 等人,2021 年
- “不按套路使用 GPT-3:成本锐减 40 倍,速度提升 5 倍”,Pullen,2023 年
- 高频交易:“意外成立的高频交易公司”
- 深圳
- 组织机构:
- WhatsApp(2013 年:“50 名员工”服务两亿用户;2015 年:50 名“工程师”服务 9 亿用户)
- Craigslist(2017 年:约 50 名员工)
- Instagram(2012 年被 Facebook 收购时:13 名员工;架构)
- YouTube(2006 年被谷歌收购时:约 10 名员工)
- Reddit(2011 年:4 名工程师;2021 年:员工总数约 700 人,超 5200 万用户)
- 维基媒体基金会(2021 年的“互联网托管费”:240 万美元)
- 推特:马斯克收购后裁掉了高达 90% 的员工和承包商;推特前员工曾普遍断言该网站会在一两个月内崩溃(甚至是无法恢复的彻底崩溃),结果证明是错的。
- 另见:“一群人共同快速实现宏伟目标的一些案例。”
一个新手正试图通过关机再开机,来修好一台出故障的 Lisp 机器。
Knight 看见这个学生的举动,严厉地说:“连到底是哪里出了错都没搞懂,你是没法只靠重启电源就把机器修好的。”
说完,Knight 把机器关掉,又开了一次。
机器修好了。
“Tom Knight 与 Lisp 机器”,出自《人工智能公案》(AI Koans)
脚注
[1] 哪怕半导体技术停滞,AI 的规模扩张依然能继续,尤其是在自我优化堆栈的加持下;在谈及 Seymour Cray 时,John Carmack 指出:“如今的超大规模数据中心乃至国家级超级计算机,架构都非常松散。但如果挑战所迫,未来也许会出现十万亿亿次(zettaflops)级别、高度集成、低延迟的计算矩阵,将十亿瓦的功耗全部消散在满满一池子循环流动的氟化液中。”
[2] 一个相关的例子是亚马逊给出的托管 WordPress 博客的“最佳实践”:
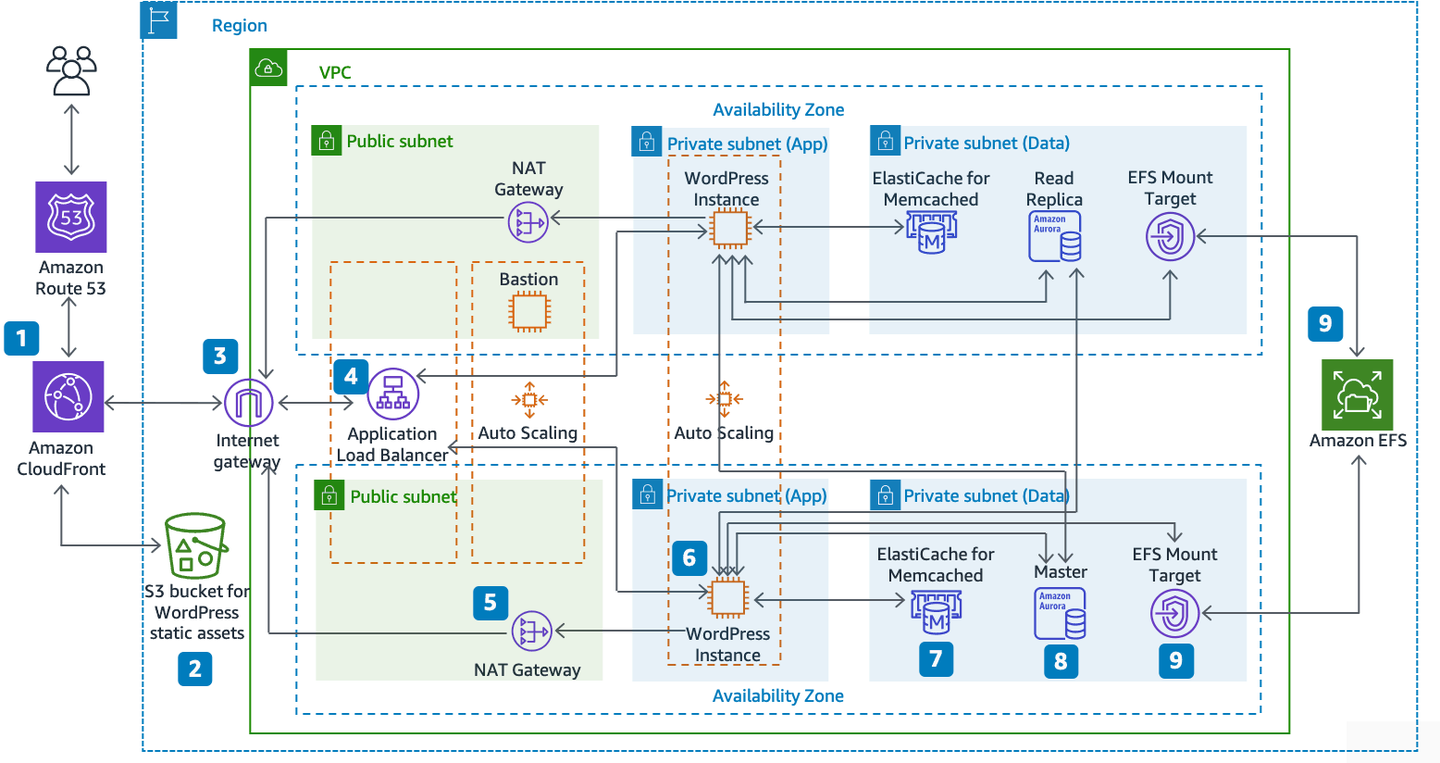
“在 AWS 上托管 WordPress 的参考架构:GitHub 上提供的这套 AWS 托管 WordPress 参考架构概述了在 AWS 上部署 WordPress 的最佳实践,并包含了一套助你快速部署运行的 AWS CloudFormation 模板。下方架构图正是基于该参考架构设计的。本节余下部分将回顾做这些架构选择背后的原因。”
Thoughts Memo 汉化组译制
感谢主要译者 gemini-3.1-pro,校对 Jarrett Ye
原文:Computer Optimization: Your Computer Is Faster Than You Think · Gwern.net